
上一篇把檢索拆成三步:切塊、向量化、算距離。拆完之後知識庫不再是黑箱,但整篇有一個問題沒有回答:你怎麼知道它搜得準?
這筆帳第 5 篇就記下來了。那一篇說知識庫大到接近窗口上限,Claude 會自己改用檢索,而官方說切換之後「回答的準確度與直接放進脈絡一致」。我當時寫的是:它在你背後換了做法,你的分數有沒有掉,只有你自己量得出來。
今天就是來量的。這是第三層「外部知識」的第四篇,要做的事只有一件:替一個你看不到的步驟,做一把尺。
這一層已經走了四篇,先用一張圖把走過的路擺在一起:
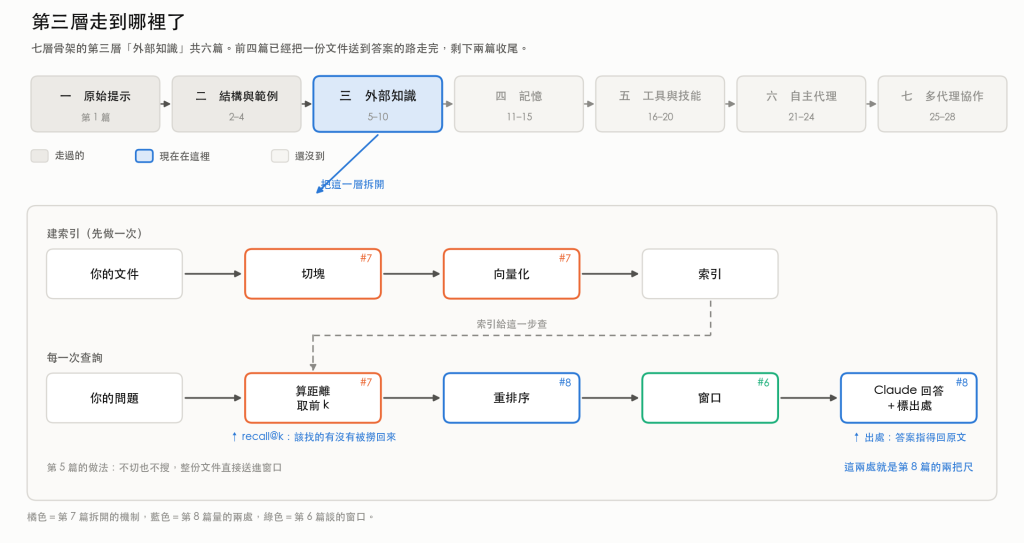
上排是先做一次的事,下排是每一次查詢都要重跑的。上一篇拆的是橘色那三格,第 6 篇談的是窗口,而第 5 篇根本不走這條管線:不切也不搜,整份送進窗口。今天要量的是藍色那兩處:撈回來的那幾塊裡有沒有你要的,以及答案指不指得回原文。
這個實驗不用寫程式,也不用金鑰,但它做出來的東西你明天還會用到。
第一步:打開你在 Claude 裡那個放了知識庫的專案,隨便挑一份文件,翻到一段只有那一段答得出來的內容,照著它寫一個問題。把「問題」跟「那一段在哪份文件的哪裡」記在同一行。
這一行就是一筆黃金配對(golden pair):你事先知道正確答案該從哪裡來。
第二步:開新對話問那個問題,然後追問一句「這是哪一份文件的哪一段?」。比對你手上那一行,它指的是不是同一段?
第三步:重複五次,用五份不同的文件。
五題裡它指對幾次,就是你的知識庫第一個真實的檢索分數。不是廠商的數字,不是論文的數字,是你自己那批文件上的數字。
你剛剛做的就是這一篇要講的全部:先有配對,才有分數。 剩下的問題只是怎麼從五筆變成五十筆、以及怎麼不靠自己的眼睛核對。
第 5 篇講過一個常見的困惑:明明上傳了,它還是答錯,因為它沒讀到對的那一段。現在把這句話拆開,因為它其實是兩種不同的失敗。
RAG(檢索增強生成)從頭到尾是兩段,中間有一個交接:
交接處就是那幾塊文字。所以答案爛掉有兩種完全不同的原因:對的那一段根本沒被撈出來,或是撈出來了,但它讀了沒用上。
而且這件事你躲不掉:第 5 篇講過,Claude 專案的知識庫大到接近窗口上限就會自動切換成檢索。你沒有決定要用 RAG,但你的答案品質已經綁在檢索上了。
| 面向 | 沒被撈出來 | 撈出來但答錯 |
|---|---|---|
| 壞在哪一段 | 檢索 | 生成 |
| 你要量的 | 召回率(recall):該找到的有沒有在撈回來的那幾塊裡 | 答案對不對、有沒有引用到正確的段落 |
| 怎麼修 | 換切塊、換向量模型、加重排序、加大 top-k | 改提示詞、要求出處、換模型 |
| 症狀 | 它說「文件裡沒有提到」,但你知道有 | 它引用了一段不相干的話,講得很篤定 |
想通這件事,很多「改了以為變好」的經驗就解開了:分不出這兩種,你所有的調整都是猜的。 改了提示詞,分數上升,你以為是提示詞的功勞,其實是那一次剛好撈到對的段落。
所以今天這一篇是兩把尺:召回率管前半段,出處管後半段。
說穿了,召回率的算法很單純:你有一組「問題 → 正確段落」的配對,讓系統跑一次,看正確段落有沒有出現在它撈回來的前 k 塊裡。 十題裡有八題在,召回率就是 0.8。
這個數字的正式寫法是 recall@k(recall at k,前 k 名召回率)。@k 是資訊檢索的慣用記法,意思是「只看排名前 k 筆」,所以 recall@5 跟 recall@100 是兩個不同的數字:報一個召回率卻不講 k,等於什麼都沒報。 k 要用你實際會送進窗口的塊數,不是挑一個好看的。
難的不是算,是那組配對哪裡來。還沒有使用者,就沒有真實問句;沒有標註人力,就沒有人幫你標哪一段是對的。
業界的做法是反過來:不從問題出發,從你已經有的段落出發,讓模型替每一段寫問題。 這件事在檢索研究裡是有出處的。
InPars(Bonifacio et al., 2022)用少樣本提示詞把模型當成合成資料產生器,只用生出來的資料微調就勝過 BM25 這種強基準。Promptagator(Dai et al., 2022)更極端:每個任務只給不超過 8 個例子,做出來的雙編碼器在 11 個檢索資料集上平均贏過 ColBERT v2 超過 1.2 個 nDCG(normalized discounted cumulative gain,排得越前面加分越多)。
這兩篇原本要解決的不是你的問題。 它們生資料是為了訓練檢索器,你要的是評估。借的是同一個動作(讓模型替你的段落寫問題),不是它們的結論,所以那些分數不能拿來當成「你的知識庫會有多準」。
落到你身上:從知識庫抽 30 到 50 個段落(要涵蓋不同文件、不同主題),請模型替每一段寫 1 到 2 個「只有這一段答得出來」的問題,存成「問題 → 段落 id」,然後跑檢索算 recall@k。最後一定要人工抽看 10 題。
這組檔案長相很樸素,一行一題就夠:
# eval-retrieval.tsv    問題 <TAB> 正確段落的 id
內部 API 的分頁參數叫什麼?      api-guide.md#分頁
正式環境固定什麼時候部署?        ops-runbook.md#部署時程
退款要幾個工作天?               policy-2026Q3.md#退款
跑一次檢索,把每一題撈回來的前 k 塊記下來,對一下正確答案在不在裡面。攤開來大概是這樣(下面是格式示意,不是實跑結果):
| # | 正確段落 | 撈回來的前 5 塊裡有什麼 | 中了嗎 |
|---|---|---|---|
| 1 | api-guide#分頁 |
api-guide#分頁、api-guide#排序… |
✔ |
| 2 | ops-runbook#部署時程 |
ops-runbook#回滾、ops-runbook#警告… |
✘ |
| 3 | policy-2026Q3#退款 |
policy-2025Q4#退款、policy-2026Q3#出貨… |
✘ |
三題中一題,recall@5 就是 0.33。而這張表比那個數字有用:第 2 題撈回的是同一份文件的鄰居,那是切塊或排序的問題;第 3 題撈回的是去年那份同名段落,那是知識庫該下架卻沒下架,第 5 篇講過的那種沉默過期。同一個分數,底下是兩種完全不同的病。
抽看是為了抓一種特定的壞題目:模型會照抄字面。它看著那一段寫問題,很容易把關鍵詞原封不動搬進去,那一題就變成「字面重合度測驗」,召回率虛高,換一個真實使用者用自己的講法問就垮。看到這種,改寫或丟掉。
這組配對是資產,不是這一次調參的耗材。 換切塊、換向量模型、加不加重排序,都用同一組題目重跑,分數才比得起來。它跟第 4 篇那 10 題是兩把不同的尺:那把量「它答對沒有」,這把量「它有沒有拿到對的那一段」。 兩把要分開看,因為答對了但檢索沒找到,代表那題是靠參數記憶答出來的,換一題公司內部的事就原形畢露。
第 6 篇欠了一筆帳:那一篇點名重排序(re-ranking),說這一層後面會專門講。就是這裡。
問題出在上一篇那個算距離的步驟:向量檢索是把問題跟每一塊分開編碼,再比距離。分開編碼才快,快到可以對幾十萬塊即時算完,但也代表模型從頭到尾沒有把「這個問題」跟「這一塊」放在一起看過。
重排序器做的正是那件被省略的事。Voyage 的官方文件講得很清楚(2026-09-22 查):重排序器是交叉編碼器(cross-encoder),把查詢與文件成對一起處理,所以相關性判斷更準;實務上的標準做法,就是先用向量檢索或關鍵字檢索(BM25)撈出候選,再用它重排前面那幾十筆。
這件事有多值得做,一篇很老的論文就給過數字。Passage Re-ranking with BERT(Nogueira & Cho, 2019)只是把 BERT 拿來替「查詢加段落」這一對打分,就在 MS MARCO 段落檢索榜上登頂,MRR@10 相對前一個最佳成績提升 27%(mean reciprocal rank at 10:第一個正確答案排第幾名就取幾分之一)。七年前的模型,但那個結構沿用到今天每一個重排序器。
實際可用的型號,官方文件列的是 rerank-2.5 與 rerank-2.5-lite(正式版),以及預覽中的 rerank-3 與 rerank-3-lite,脈絡長度都是 32,000 詞元(2026-09-22 查)。
為什麼不直接用重排序器搜整個知識庫? 因為成對處理的代價就在這裡:向量檢索可以先算好、存起來,重排序每一次查詢都要把問題跟每一筆候選重跑一次。所以它只能放在漏斗的第二層:向量撈 50 筆,重排序挑 5 筆。
漏斗一疊起來,兩把尺的分工就清楚了:第一層要的是召回率,寧可多撈一點,反正後面會篩;第二層要的是前幾名準,因為那幾塊才會真的進窗口,而第 6 篇算過不相關的東西進窗口的代價。
第 5 篇那個實驗的第二步,是追問一句「這是文件裡哪一段講的?」。那是手動版本,API 上有一個開關做同一件事,而且比追問可靠。上一篇說過 Claude 在這條鏈上只負責最後一端:拿到那幾塊之後回答,並且標出處。這一節就是那一端。
引用(citations) 是 Claude 的 document 區塊上的一個欄位,預設不開。官方文件的第一句話就是它的用途(2026-09-22 查):引用會回傳支持每一句主張的確切段落,讓你可以驗證答案、也可以把出處呈現給使用者。所有 active 模型都支援。
值得看的是它跟「請你附上原文」這種提示詞寫法差在哪。官方文件自己列了兩點:
cited_text 直接從你給的文件裡抽出來,所以官方的用詞是「保證是指向所給文件的有效指標」。你請模型自己抄原文,它抄錯或抄一句不存在的話,你不會知道。
cited_text 不計入輸出詞元,下一輪把它傳回去也不計入輸入詞元。開引用會讓輸入詞元小幅增加(系統提示詞與文件切塊),但引用本身這一段是不收錢的。還有一個細節,正好接上上一篇整篇在講的事:引用的粒度,就是文件被切塊的粒度。 官方文件寫的是:純文字與 PDF 會自動被切成句子,模型可以引一句,也可以串起連續幾句引一整段;而自訂內容區塊(custom content)不做額外切塊,你給幾塊就是幾塊。
所以官方對 RAG 的建議很直接:想讓它引用到你那幾塊 RAG 切塊裡的句子,就把每一塊放成一份純文字文件;不想再被切,就用自訂內容區塊。 你在上一篇調的那些切塊參數,在這裡第二次決定了使用者看到什麼。而這幾塊到底要跟系統提示、範例一起怎麼排進同一個請求,是這一層最後一篇的事,那時候切塊粒度會第三次回來找你。
一個限制要先知道:PDF 裡的圖片目前不能被引用,所以沒有可抽取文字的掃描檔根本不可引。
上一篇留了一筆沒還的帳:官方文件叫你「自己評估多家供應商」,卻沒有告訴你怎麼評估。
評估的起點是 MTEB(Muennighoff et al., 2022),文字向量模型的大型基準測試:8 類任務、58 個資料集、112 種語言,論文本身評測了 33 個模型,還附一個公開排行榜。
但它最該被引用的不是排名,是結論:「沒有任何一種文字向量方法在所有任務上都佔優。」 作者的解讀是,這個領域還沒有收斂出一個通用的最佳做法。
所以排行榜的正確用法是縮小候選,不是選出答案:
| 你要做的 | 為什麼 |
|---|---|
| 先看跟你的任務同類的那一欄(檢索,不是分類或分群) | 排行榜的總平均把八類任務混在一起,跟你的用途沒有關係 |
| 篩掉語言撐不住的 | 名次是分語言的。MMTEB(Enevoldsen et al., ICLR)把 MTEB 擴成 250 種以上語言、500 多個評測任務,而它量到的最好成績是分散在不同語言子集與任務類別上的。英文榜上的第一名,沒有承諾過你的語言 |
| 留 2 到 3 個候選,用上一節那組配對各跑一次 | 這才是你的語料上的數字 |
同一篇也量到:公開模型裡最好的是只有 5.6 億參數的 multilingual-e5-large-instruct,不是那些幾十億參數的大模型。向量這一格,大不等於好。
排行榜第一名不是你的第一名。 這句話在第 4 篇已經用另一種形式說過一次了,那時候講的是提示詞:改好了沒有,要靠量測,不是靠相信。今天只是把同一句話套到另一個零件上。
上一篇的結論是切塊器與向量模型都不會報錯。這句話可以自己去確認:Voyage 的錯誤碼表從頭到尾只有請求層的錯(400 請求寫壞、401 金鑰、403 來源 IP、429 太頻繁),服務等級目標保的是 api.voyageai.com 每月 99.5% 的可用率,而 dashboard 管的是組織、專案、金鑰與預算(以上 2026-09-22 查)。整條鏈上沒有任何一個地方,會跟你說「這一次檢索失敗了」。
所以儀表要自己裝。四件今天就能做的事:
| 做法 | 為什麼 |
|---|---|
| 記錄每一次檢索的問題、撈回來的塊 id 與分數 | 答案怪的時候,你才查得到它當時看到了什麼。沒有這一行日誌,你連重現都做不到 |
| 替相似度分數訂一個下限,低於下限就讓它說不知道 | 第 5 篇講過模型寧可猜也不空白,而檢索一定會回傳最像的幾塊,就算裡面沒有答案 |
| 每一塊都連同向量模型名稱與切塊參數一起存 | 換模型等於整個索引重算,有這個欄位你才分得出來是哪一批壞掉的 |
| 定期用那組配對重跑一次召回率 | 知識庫會長大,分數會漂移。第一次量是基準,之後每次都是比較 |
這四件事沒有一件是廠商會替你做的。 它們也不難,難的是在還沒出事之前就去做。
這幾個都是開源的現成工具(星數與授權 2026-09-22 查):
| 你要的那一件 | 現成的 | 要注意 |
|---|---|---|
| 把每一次檢索留成一條可以點開的紀錄 | Langfuse(3.4 萬星)、Phoenix(1.1 萬星) | 開源的追蹤平台,把問題、撈回來的塊、分數與回答串成同一條紀錄。先裝這個,沒有紀錄,後面三件都做不動 |
| 算 recall@k、nDCG、MRR | ranx(MIT)、ir_measures(Apache-2.0) | 資訊檢索界的標準算分工具,吃的就是「問題 → 正確文件」這種格式,配對直接餵得進去 |
| 檢索與回答一起評分 | Ragas(Apache-2.0,1.5 萬星) | RAG 專用指標:context precision/recall 管前半段,faithfulness 管後半段。但它 2026 年 2 月換了擁有者(explodinggradients → vibrantlabsai),推進也停在那時候,用之前先確認它還活著 |
| 放進 CI,每次改索引都重跑 | promptfoo(MIT)、DeepEval(Apache-2.0) | 都能把評估集寫成設定檔或 pytest 風格的測試。評估集只有進了 CI 才會真的被跑。 |
工具之外,兩個技巧不用裝任何東西:
你多了一組要維護的題目。 那組「問題 → 正確段落」的配對,文件改版了它就會過期:段落被改寫、文件被下架,題目的答案就變成錯的。它跟知識庫一樣會沉默地過期,而且過期的評估集比沒有評估集更糟,因為你會相信它給的分數。
漏斗多一層,延遲多一段。 重排序每一次查詢都要重跑。撈 50 筆排 5 筆是個起點,但那個「50」要自己量:撈太少,重排序救不回沒撈到的;撈太多,使用者等著。
你開始為「被找得到」而寫東西。 第 5 篇說檔名突然變成一條技術建議,那時候是第一次。現在同一件事延伸到了文件內部:段落要不要自帶標題、一段講幾件事、要不要在開頭寫清楚這一段在講什麼。寫文件的人從此多了一個讀者,而那個讀者只看得到被切出來的那一塊。
出處是給你核對用的,不是給你炫耀用的。 引用讓答案變得可以查證,但它只保證那句話真的出自那份文件,不保證那份文件是對的。一份過期的定價文件被準確引用,還是一個錯的答案。
這一層的帳到這裡還沒結完:供應商、維護、量測、窗口,四筆分散在第 5 到第 8 篇,這一層的最後一篇會把它們一次算清楚,順便把前兩層散落的零件組成一個真的送得出去的請求。
多了什麼能力:檢索從「感覺還可以」變成一個數字。你有一組自己的黃金配對、一個 recall@k、一層把前幾名排準的重排序,以及一個能指回原文的出處。答錯的時候,你分得出來是沒撈到還是沒讀懂。
多付了什麼代價:一組會過期的評估題目、一層要錢也要時間的重排序、一個每次改索引都要重跑的流程,以及一個更難受的事實:你量得到檢索對不對,量不到文件本身對不對。
既然窗口有 100 萬詞元,為什麼不整包塞進去就好?
這一篇量的是「找得到」,而上面所有的工夫,都建立在「東西塞不進去」這個前提上。下一篇拆的就是那個前提:100 萬這個數字是怎麼來的、大海撈針測試過關代表什麼又不代表什麼,以及為什麼基準測試量的是機制,你的評估集量的是你的任務。


 iThome鐵人賽
 看影片追技術